
让同一个角色出现在多条 AI 视频里
用三张参考图组、锁定不能变的部分、列出可以变的项目,并用末帧串接,让角色在每条镜头里都还是同一个人。
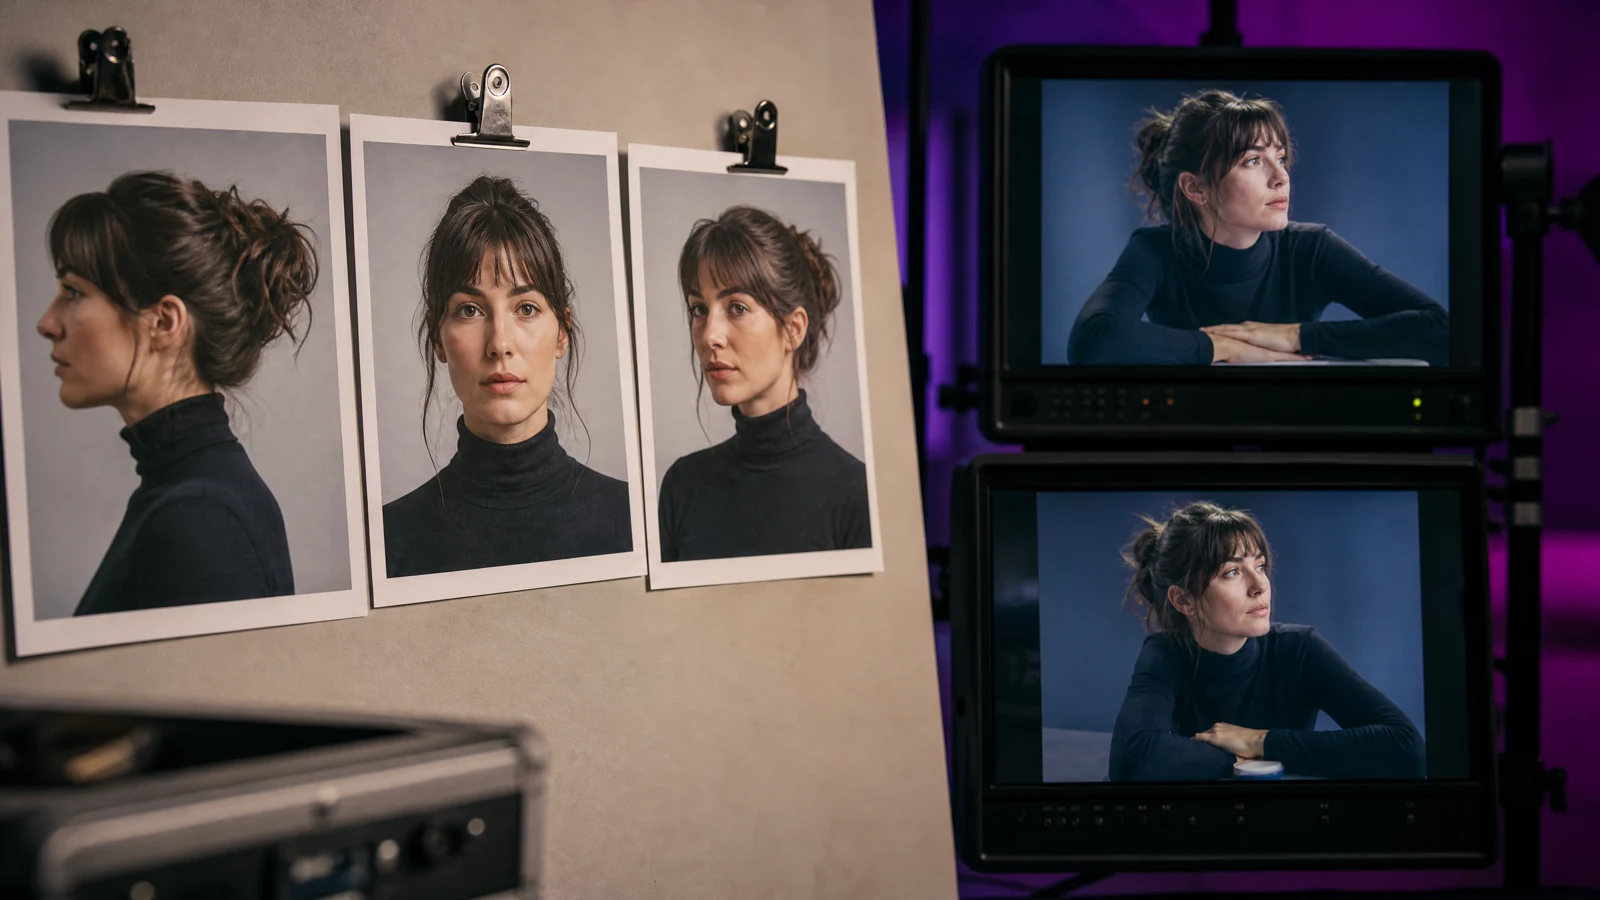
一条片子很简单。同一个角色的五条片子剪在一起,大多数 AI 视频项目就是在这儿垮的:外套颜色变了、头发长长了、第二镜和第四镜之间脸像换了个十年。
参考图生视频就是为这个问题存在的。不用文字描述角色,直接把图片交给模型,让图片去承载设计。参考图生视频指南讲模式,这一页讲围绕它的操作流程。
先准备参考图集
三张图,准备一次,整个系列复用:
- 正面清晰照。 脸在中间,光均匀,表情中性。
- 四分之三侧脸照。 同一个人、同一套光,让模型学到形状而不只是一个角度。
- 全身照。 交代服装、比例和鞋子。
图集的规则:
- 同一角色、同一套服装,最好同一天拍。
- 纯色背景。花背景会被学成角色的一部分。
- 不要重滤镜、不要磨皮、不要遮住眼睛的墨镜。
- 用你手上最高分辨率的原图,别裁。
如果这个角色只以生成图存在,先针对同一张静图生成四版,挑解剖结构最干净的那张。参考图集会继承原图的毛病。
锁住设计,变化镜头
两条片子之间保持不变的有:
- 参考图本身。
- 提示词里描述角色的那句话,一字不改。
- 画幅和分辨率。
- 模型,以及快速/标准档位。
只改场景那一句和镜头那一句。全部技巧就这一条,而且它无聊得很故意:你动的每一个别的变量,都是设计漂移的一次机会。
能撑住一个系列的提示词
参考: 以附上的角色图为身份参考,保持脸型、发型、眼睛颜色、服装和身体比例与参考完全一致。 场景: 角色走在雨夜的夜市里,霓虹招牌倒映在积水中。 镜头: 胸高慢速横移跟拍。 防错: 每一帧都是同一个角色,不换装、不要多出人物、不要文字、解剖自然。
提示词实验台
先生成前改好一条验证过的提示词
选一个方向,把细节改成你原图的样子,然后复制提示词,或直接带着提示词打开工作台。
多个镜头保持同一张脸。
浏览和复制提示词免费。生成消耗已购买积分,工作台会在开始前显示消耗。
注意参考那段点名了它在保护什么——脸型、发型、眼睛、服装、比例。"保持角色一致"这种笼统说法等于让模型自己定义什么叫一致。
每条片段后的漂移检查
在下一条之前做,而不是等到第十条:
- 脸: 眼距一样、下颌线一样。
- 头发: 长度和分缝一样。
- 服装: 颜色一样、可见的层数一样。
- 比例: 头相对肩的大小没变。
- 风格: 整条是一种质感,不是一半照片一半插画。
五条里错两条,就修图集或那句角色描述。用同一段提示词重生成、只改场景句,会稳定地把同样的漂移再演一遍。
不用切镜的接镜法
最便宜的连续性来自复用最后一帧。让工作区返回片段的末帧,再把这一帧当作下一条的原图。角色的承接是精确的,因为它就是同一批像素。
适合用的时候:
- 两个镜头在同一地点。
- 需要跨一个节拍做平滑运镜。
- 下一镜从上一镜结束的地方开始。
地点变了、时间跳了就不要用:锁死的起始帧会跟新的场景描述打架。
老实说,还会坏的地方
- 快速转身。 侧脸是身份最弱的角度,转头要慢。
- 手挡脸。 遮挡比距离更让身份判断出错。
- 人群。 提示词里有"路人"就会真的进来路人,而且模型可能把参考脸换到他们身上。
- 中途换风格。 一个系列只用一种质感;参考图生视频保得住身份,保不住美术方向。
常见问题
需要几张参考图?
认得出脸最少两张;加上一张全身照的三张能同时守住服装和比例。如果几张图的光线各不相同,加图并不能自动变好。
可以用真人的参考图吗?
必须本人同意。把别人的照片拿去建角色是权利问题,可接受使用政策同样约束产出。
所有片段要一样长吗?
会剪在一起就必须一样。长度混了会打乱模型学到的节奏;画幅混了更糟,等于在镜头之间给角色重新构图。
Was this guide useful?