
用 AI 让照片动起来:六步循环
一套把任意静图变成可发布片段的循环:原图检查、画幅、动作句、防错、验收,以及每轮只改一处。
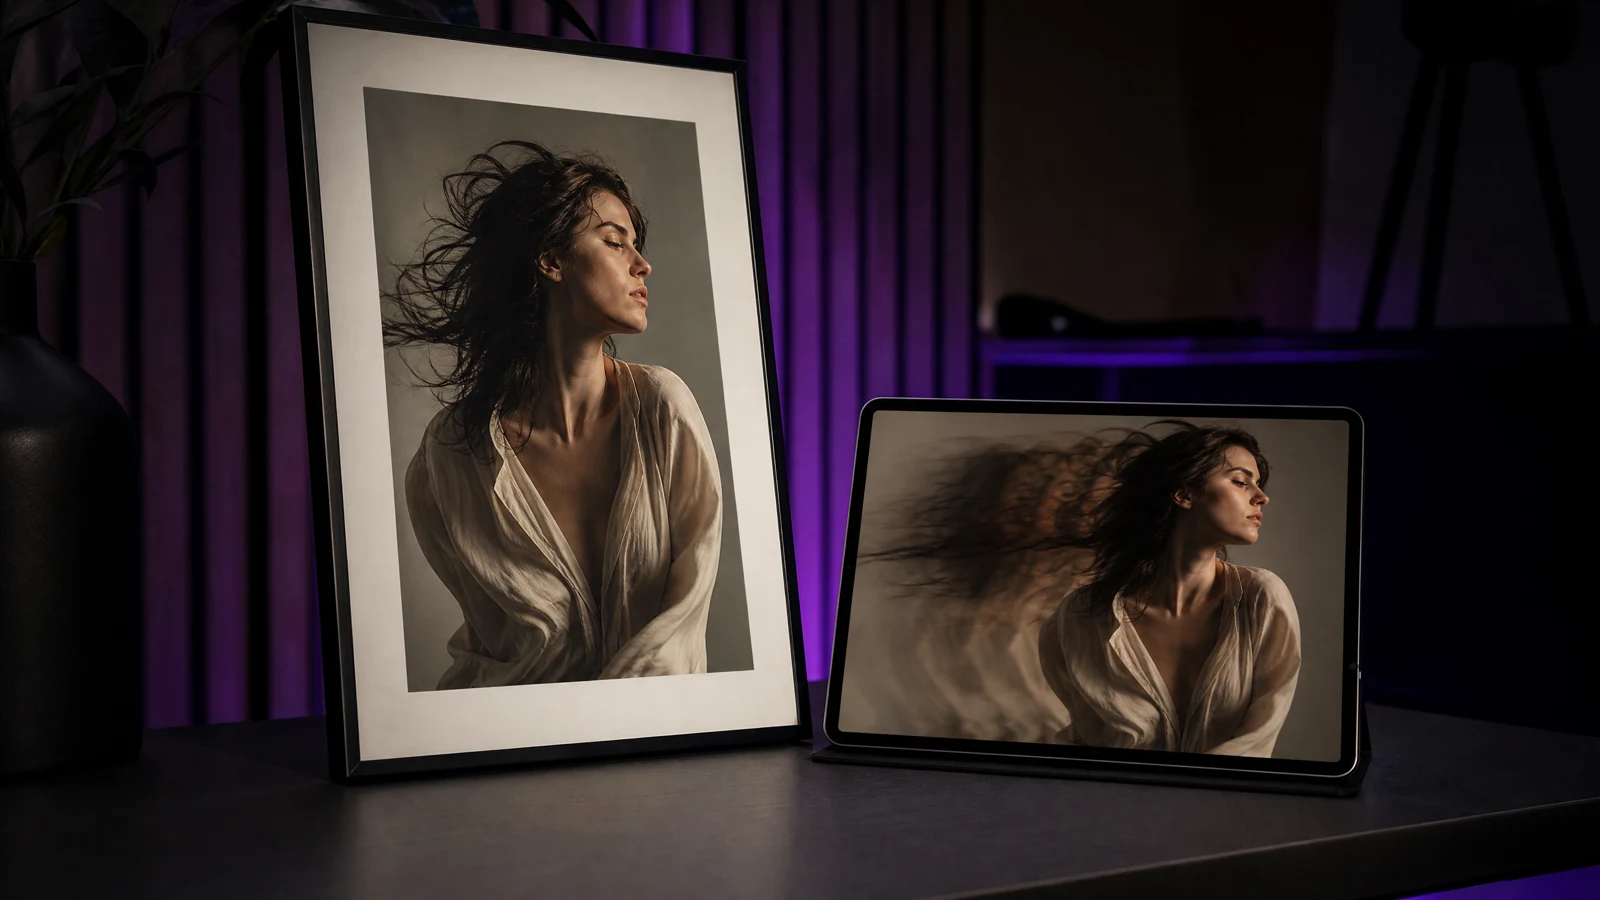
大多数难看的 AI 照片动画不是模型不行,而是流程不行:一张根本动不起来的照片、一句话里塞了三个动作、画幅选错,以及第六次重试前从来没验收过一次。
下面这套循环能把上面四个错误去掉。一张照片到一个片段大约十分钟,旁边开着图生视频指南就能做完。
第一步:挑一张动得起来的照片
适合做动态的静图有四个特征:
- 主体清楚,不是一群人。
- 想做身体动作时,全身都在画面里。
- 正面光或侧光,不是强烈逆光。
- 主体和背景之间分得开。
把原图放大到 100% 看手和发际线。那里的畸变会被模型第一个放大。如果照片噪点多、糊、或者滤镜很重,换一张重拍比重试划算。
第二步:只选一个动作,不要选一个场景
先用一句话写下你唯一想看到的变化,从下面选一类:
- 镜头动作(推近、横移、环绕)。
- 身体动作(转头、眨眼、迈一步、挥手)。
- 环境动作(风、雨、流动的光)。
只选一个。想要两个,就生成两条再剪在一起。一句话同时要转头、推镜和落叶的提示词,通常交出三个都做了一半的动作,再加一张变形的下巴。
第三步:用四段式写提示词
本站上稳定的提示词都是同一个骨架:
- 锁定参考图。 "以上传的照片为起始帧,保持脸、服装和背景布局不变。"
- 动作。 "镜头平稳缓慢地推近。"
- 质感。 "头发和衣料随微风轻轻移动。"
- 防错。 "不要切镜、不要出现文字、不要多出人物,解剖结构稳定。"
提示词实验台
先生成前改好一条验证过的提示词
选一个方向,把细节改成你原图的样子,然后复制提示词,或直接带着提示词打开工作台。
镜头平稳推近主体。
浏览和复制提示词免费。生成消耗已购买积分,工作台会在开始前显示消耗。
上面的实验台加载了三组已验证预设。复制一组,只改动作那一句,另外三部分原封不动。锁定句和防错句是用来压制漂移的,不是装饰。
第四步:让输出匹配投放位置
- 9:16 用于快拍、Reels、Shorts。
- 16:9 用于落地页首屏或 YouTube 前贴。
- 1:1 用于两边都会裁的瀑布流位置。
- 3:4 / 4:3 当原图本来就是这个比例时——提示词里裁得越少,边缘凭空补出来的内容越少。
长不等于好。三到五秒能干净循环、加载快,也在多数平台自动播放的时长限制内。更长的片段留给真有镜头运动的镜头。
第五步:只生成一条,然后停下
先把第一条完整看一遍,再说要不要重做。然后过一遍验收清单:
- 脸:同一个人,表情方向一致。
- 手和手指:每只手五根,没有多余的关节。
- 边缘:头发、眼镜、肩膀没有闪烁。
- 背景:没有凭空出现的物体,家具没有被复制。
- 文字:没有生成你没要求的字母或标志。
五条里过三条,这条就能用。小问题留给剪辑,不要再生成一次。
第六步:按顺序修
结果不行时,每次只改一个变量,顺序是:
- 缩短时长。 大部分不稳定都发生在片段后段。
- 减小动作。 "缓慢推近"而不是"快速变焦"。
- 回看原图。 静图里已经变形的手,提示词救不了。
- 简化背景。 物体越少,出错机会越少。
- 补一条负面约束。 "不要扭曲、不要多肢体、不要文字。"
- 提高输入质量。 一张干净的高分辨率原图胜过任何形容词。
不要加"8K、杰作、超精细"。这些词修不好解剖结构,而且和一句有用的指令一样要花积分。
什么时候不要让照片动
群体照、身体互相遮挡、主体小于画面三分之一、或者画面里必须看清文字时,跳过图生视频。这些情况用一张静图加文字覆盖,既便宜又可靠。
生成消耗购买来的积分,工作区会在开跑前显示预估。浏览提示词和预设不花钱,剪辑成品用的浏览器工具在本地运行,不用账号。
常见问题
一条片段要生成多久?
几秒钟的视频通常一两分钟出结果。排队时间随负载变化,工作区会显示任务状态,可以关掉页面。
可以给不认识的人的照片做动画吗?
只有拿到对方许可才行。上传真人照片并发布成品,是权利与隐私问题,不是技术问题。可接受使用政策适用。
为什么片段结尾脸会变?
通常是对动作的描述而言片段太长了。缩短时长,并把锁定身份的句子放在提示词开头和结尾。
Was this guide useful?